Sur un gros projet, je n'arrive pas à faire confiance à l'IA sans tout relire. Ce n'est pas de la méfiance de principe : j'ai testé, petit à petit, une confiance plus large — et à un moment, ça dérive. Alors je vérifie tout. Et tout vérifier, sur un projet qui avance à la vitesse d'un agent, ça m'épuise.
Le problème, c'est que la vitesse de l'IA n'est pas le temps humain. J'ai l'impression de piloter une armée de développeurs qui alternent junior et expert d'une tâche à l'autre, qui suivent les instructions ou n'en font qu'à leur tête — comme des humains, mais cent fois plus vite. Rester au centre, à tout auditer, à tout voir passer, ça finit en épuisement pur. Et en même temps, je sens bien la transformation : pourquoi passer six mois à faire, imparfaitement, à la main, ce qu'une IA fait en une semaine ? Je ne l'ai pas tranché. Cette question-là reste ouverte, et ce billet ne prétend pas la fermer.
Ce qui m'a débloqué, en revanche, c'est de comprendre que ce sentiment d'épuisement n'était pas un manque de discipline de ma part. C'est un mécanisme connu, mesuré, et il a un nom.
Une étude du BCG a chiffré ce que je vivais sans le savoir : surveiller étroitement des agents IA est la forme d'engagement la plus coûteuse mentalement qu'ils aient mesurée — +14% d'effort mental, +12% de fatigue, +19% de surcharge d'information. Et le mécanisme derrière n'a rien de nouveau : il est documenté depuis la Seconde Guerre mondiale, dans une étude de Mackworth sur des opérateurs radar chargés de surveiller un écran en continu. Leur taux de détection chutait de 10 à 15% dès les trente premières minutes de surveillance, et continuait de se dégrader ensuite. Ça a un nom : le "vigilance decrement". Une attention humaine ne tient pas en continu, peu importe la volonté qu'on y met — ce n'est pas conçu pour ça.
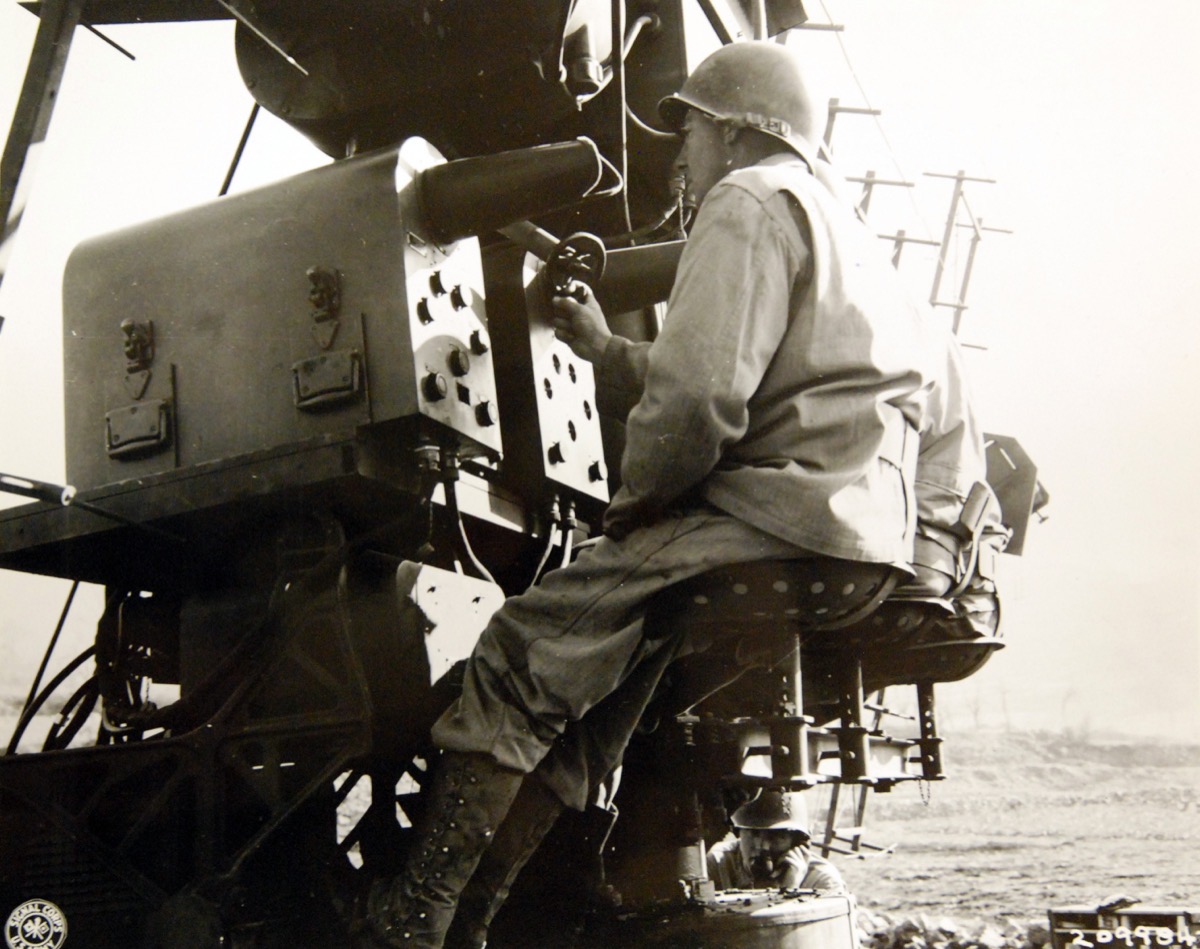
Une phrase de cette recherche m'a particulièrement parlé : on ne soutient pas la vigilance par la volonté sur des centaines de répétitions par semaine ; on la soutient quand le système ne sollicite le jugement humain que lorsqu'il est réellement nécessaire. Ce n'est donc pas à moi de tenir plus longtemps. C'est le système autour de moi qui doit arrêter de me demander la même intensité d'attention sur tout, tout le temps.
En creusant, j'ai réalisé que je posais la question au mauvais niveau. "Human-in-the-loop ou on-the-loop pour ce projet" traite le projet comme une seule unité, qui devrait mériter un seul niveau de confiance du début à la fin. C'est probablement ça qui bloquait — pas le choix lui-même, la façon de le poser.
La réponse que j'ai trouvée dans la littérature, c'est l'échantillonnage pondéré par le risque. Pas aléatoire — un tirage au sort dilue trop les échecs rares, il faut cibler. L'idée est de stratifier par signal de risque : ce qui touche un accès réseau, des identifiants, un appel d'outil sensible mérite un examen serré ; une logique avec des branches et des boucles mérite un examen moyen ; le reste peut rester léger, voire passer sans relecture. Ça rejoint un principe que Claude Code applique déjà sur lui-même : agir librement sur ce qui est local et réversible, s'arrêter sur ce qui est difficile à annuler ou a un large rayon d'impact.
Ça se combine avec un cadre à trois niveaux que j'ai fini par adopter pour parler de ça plus précisément que "je surveille" ou "je ne surveille pas" : human-in-the-loop (une approbation avant que l'action s'exécute, pour le risque élevé), human-on-the-loop (l'action s'exécute seule, je surveille et je peux intervenir pendant ou après, pour le risque moyen quand la vitesse compte et que l'erreur est réversible), et fully autonomous (aucun point de contrôle humain). Le point important, c'est que ce niveau se choisit étape par étape dans un même flux de travail, pas une fois pour tout le projet. Le brainstorm reste pour moi du human-in-the-loop, c'est là que je porte la valeur ajoutée. L'exécution de tâches bornées et vérifiables individuellement, elle, tolère très bien du human-on-the-loop.
Risque élevé
Accès réseau, identifiants, appel d'outil sensible
Difficile à annuler, large rayon d'impact
Human-in-the-loop
(approbation avant action)
Risque moyen
Logique avec branches, boucles
Local, mais pas trivial à vérifier après coup
Human-on-the-loop
(surveillance pendant/après)
Risque faible
Le reste — tâche bornée, réversible
Local et réversible
Fully autonomous
(aucun contrôle humain)
Ce qui m'a débloqué n'est donc pas plus de volonté ni une meilleure discipline de relecture. C'est d'arrêter de traiter "le projet" comme une seule tranche de confiance, et de le découper en tranches qui n'ont pas toutes besoin du même régime — décidé petit bout par petit bout, pas globalement en amont.
Reste une question que je n'ai pas résolue, et je préfère le dire plutôt que d'inventer une réponse propre : la littérature sur laquelle je m'appuie vient largement du monde devops et sécurité, où les signaux de risque sont assez évidents à nommer — accès réseau, identifiants, appels d'outils sensibles. Sur mon propre travail, en dehors de ce contexte-là, comment je définis concrètement mes propres strates de risque ? Je ne le sais pas encore précisément. C'est la prochaine chose à creuser.
Références
- The Decoder — Study warns of "AI brain fry" as workers hit cognitive limits overseeing AI agents (étude BCG / UC Riverside)
- Atomic Robot — AI review fatigue
- NHI Mastery Group — Why do random samples fail to give good AI agent eval coverage?
- Wikimedia Commons — Oscilloscope operators on an SCR 268 radar maintain watch near Menella, Italy, WWII (photo : National Museum of the U.S. Navy, domaine public)
